In den ersten aufregenden Wochen bei Oepfelbaum wurde mir die Gelegenheit geboten, mich mit einem akuten Problem eines Kunden auseinanderzusetzen. Konkret ging es darum, einen überholten Importvorgang durch die Anwendung einer vergleichsweise neuen Technologie aufzuwerten – des Event Streaming.
Ausgangslage
Bisher wurden sämtliche Daten aus dem Core-Banking täglich über CSV-Dateien geliefert – eine pro Datentyp. Ein Prozess, der auf den Abhängigkeiten zwischen den verschiedenen Datentypen basierte, übernahm anschliessend die Verarbeitung.
Bei näherer Betrachtung erschien diese Verarbeitungsmethode als recht statisch und ineffizient. Also stellten sich Fragen wie: Müssen wirklich täglich alle Daten neu importiert werden? Und wie weit lässt sich ein solcher Prozess parallelisieren? In Zusammenarbeit mit einem erfahrenen Oepfelbäumler und unserem Kunden wurden die Grundlagen für die Optimierung des Prozesses geschaffen.
Grundlagen der neuen Lösung
Die Daten sollten über Kafka, ein Tool zur Speicherung und Verarbeitung von Datenströmen, geliefert werden. Verschiedene Kanäle (Topics) sollten die alten CSV-Dateien ersetzen und durch Partitionierung eine Parallelisierung ermöglichen.
Meine ersten Schritte mit Kafka waren wie ein spannendes Experiment. Der Aufbau einer lokalen Kafka-Instanz war schnell erledigt, und die Interaktionen mit Kafka durch sogenannte «Consumer und Producer» liessen sich ohne grosse Hürden in Java implementieren.
Abstraktion der Problemstellung und Herausforderungen
Um die Abhängigkeiten zwischen verschiedenen Datentypen zu modellieren, griff ich auf Entitäten zurück, die in einer Datenbank über Fremdschlüssel miteinander verbunden wurden. Doch schon bald wurde klar, dass es die verschiedenen Arten von Abhängigkeiten waren, die die grössten Herausforderungen mit sich brachten.
Schlussendlich reicht es nicht, nur die Verbindungen zwischen den verschiedenen Datentypen zu beachten. Denn sobald man Teillieferungen erlauben möchte, muss auch sichergestellt werden, dass Updates des gleichen Eintrags in der richtigen Reihenfolge verarbeitet werden.
Kafka und Java – sonst nichts
Mein erster Ansatz bestand darin, eine Eigenkreation mit Kafka und Java zu entwickeln – im «Consumer und Producer»-Prinzip mit etwas Logik dazwischen. Doch die Komplexität stieg schnell, besonders im Umgang mit den verschiedenen Arten von Abhängigkeiten, was sich negativ auf die Performance auswirkte.
Zentral sind vor allem folgende Fragen, die ich für unseren Kunden beantwortet habe:
- Wie soll festgestellt werden, dass eine Vorbedingung erfüllt ist?
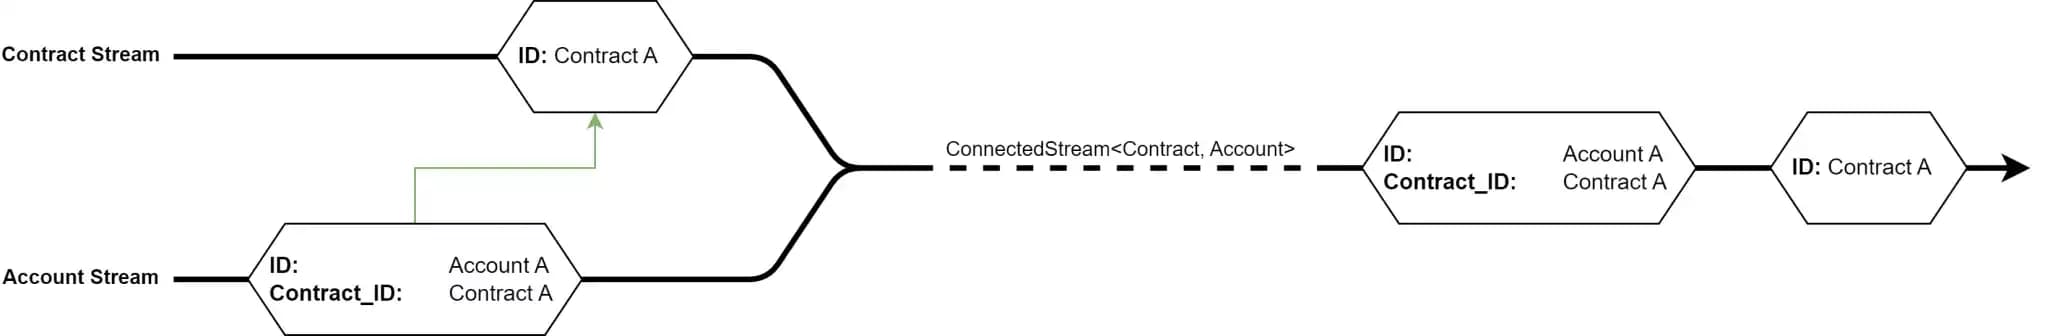
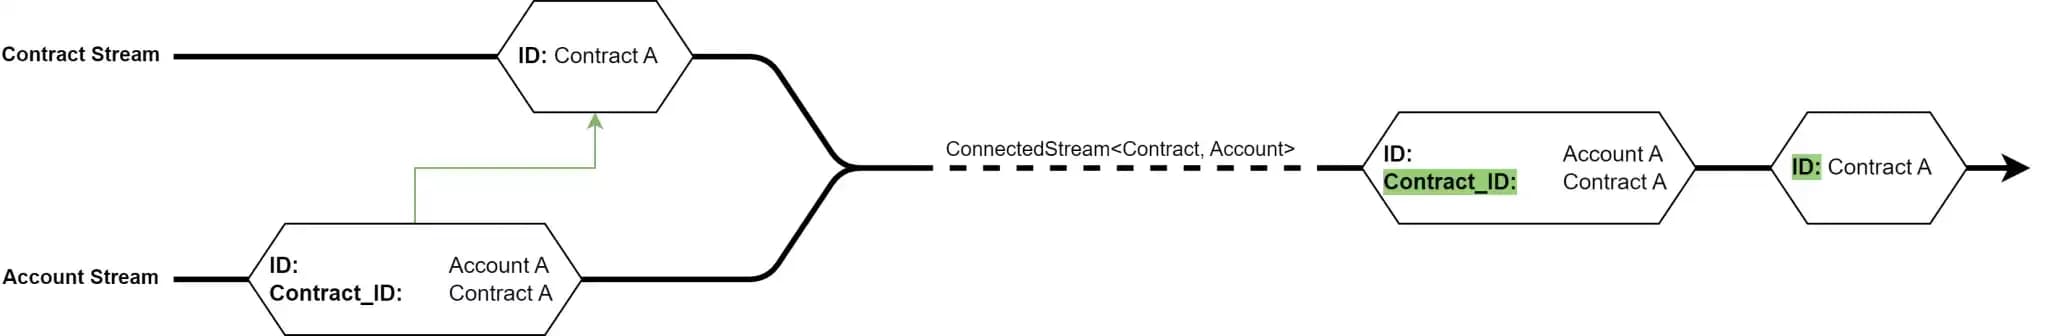
Durch den direkten Zugriff auf das Zielsystem kann geprüft werden, ob die Fremdschlüssel aufgelöst werden können.
- Wie soll die Applikation reagieren, wenn die Vorbedingung eines Eintrags noch nicht erfüllt ist?
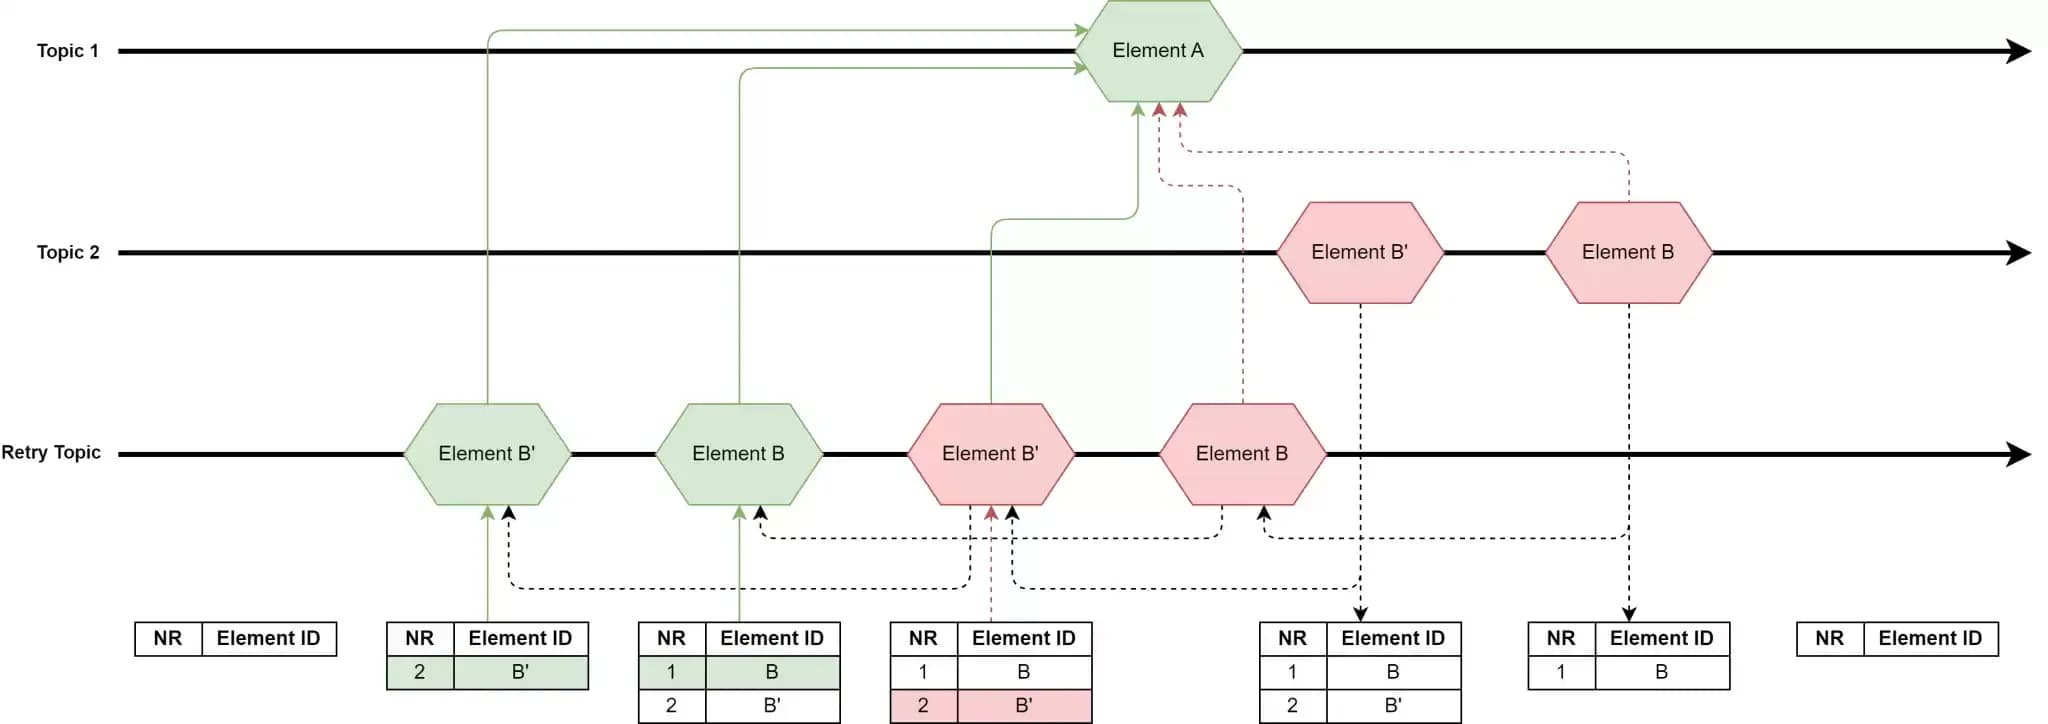
Die ID des Elements wird in einer Datenbank gespeichert, und das Element selbst wird auf einem Retry Topic publiziert.
- Was passiert, wenn mehrere Versionen des gleichen Eintrags auf eine Vorbedingung warten?
Bei der Verarbeitung wird überprüft, ob ein Datenbankeintrag mit der ID des Elements existiert. Ist dies der Fall, wird das Update auf dem Retry Topic veröffentlicht, wobei sowohl das Element als auch der Datenbankeintrag eine Sequenz-Nummer erhalten. Diese Nummer dient der Beibehaltung der Reihenfolge beim Verarbeiten des Retry Topic.
Grob zusammengefasst lässt sich der Prozess auch mit folgender Grafik beschreiben: