In der Welt des Bankings, wo jede Sekunde zählt, ist die effiziente Verarbeitung von Daten unerlässlich.
Stellen Sie sich vor, ein Kunde muss 30 Minuten warten, bis Änderungen an seinem Portfolio sichtbar werden, weil die Daten durch verschiedene Systeme laufen – ein Szenario, das in der heutigen Zeit schlichtweg inakzeptabel ist. Apache Flink bietet hierfür die ideale Lösung: ein vielseitiges und leistungsstarkes Framework, das moderne Anforderungen an die Datenstream-Verarbeitung zuverlässig erfüllt.
Was ist Apache Flink?
Apache Flink ist ein Open-Source-Framework und eine verteilte Verarbeitungs-Engine, die speziell für Berechnungen über ungebundene (und gebundene) Datenströme entwickelt wurde mit einem «state». Mit seiner Fähigkeit, in jedem gängigen Cluster-Umfeld zu laufen und Daten nahezu in Echtzeit zu verarbeiten, hat sich Flink in der Welt der Datenverarbeitung einen Namen gemacht.
Die Grundlagen: APIs und Flexibilität
Apache Flink hebt sich durch seine umfassenden und flexiblen API-Optionen von anderen Stream-Processing-Frameworks ab. Diese APIs bieten sowohl Anfängern als auch erfahrenen Entwicklern unterschiedliche Zugänge, um Datenverarbeitungsaufgaben effizient zu lösen.
Flink SQL & Table API
Die SQL und Table API sind deklarative Programmierschnittstellen. Datenverarbeitungsschritte werden bei der Flink SQL API ähnlich wie in herkömmlichen SQL-Abfragen definiert. Die Table API wiederum zeichnet sich aus durch ihre Verfügbarkeit in Java, Scala und Python. Beider dieser APIs fügen sie sich nahtlos in bestehende Entwicklungsumgebungen ein und können mit minimalem Aufwand integriert werden. Diese zwei APIs zeichnen sich durch ihre Benutzerfreundlichkeit und Schnelligkeit aus: Entwickler müssen sich darauf konzentrieren, was getan werden soll, ohne sich um die genaue Implementierung der Datenverarbeitungslogik zu kümmern. Besonders für Anwendungen, die auf einfache Datenmanipulationen oder Filtervorgänge abzielen, ist die SQL oder Table API eine ideale Wahl.
Ein Vorteil der SQL und Table API ist ihre Fähigkeit, auf hohen Abstraktionsleveln zu arbeiten. Das bedeutet, dass Entwickler mit einer einfachen Syntax komplexe Verarbeitungslogiken umsetzen können, was Entwicklungszyklen verkürzt und die Wartung erleichtert. Flink übersetzt diese Abfragen effizient in optimierte Datenverarbeitungspläne, die in verteilten Umgebungen ausgeführt werden können.
Die DataStream API
Für Projekte, die detaillierte Kontrolle über den Verarbeitungsfluss und die spezifische Implementierung erfordern, bietet die DataStream API die nötige Flexibilität. Im Gegensatz zur SQL oder Table API, die eher auf höheren Abstraktionsebenen arbeitet, ermöglicht die DataStream API eine prozedurale Programmierung. Hier können Entwickler genau festlegen, wie die Daten verarbeitet werden sollen, was sich besonders für komplexe, zustandsbehaftete Stream-Verarbeitungen eignet.
Die DataStream API unterstützt eine breite Palette von Funktionen, darunter «windowed» Operationen, die es ermöglichen, Datenströme in festgelegten Zeiträumen zu gruppieren, sowie genau definierte Event-Time-Verarbeitungen, um die korrekte Reihenfolge der Ereignisse sicherzustellen.
Integration und Flexibilität
Ein weiterer Pluspunkt von Flink ist die nahtlose Integration dieser APIs. Entwickler können beispielsweise Flink SQL nutzen, um eine schnelle Abfrage zu starten, und in einem anderen Fall die DataStream API, um tiefergehende, maßgeschneiderte Verarbeitungslogiken einzubauen. Dies eröffnet die Möglichkeit, Anwendungen zu erstellen, die sowohl einfache Datenabfragen als auch hochkomplexe Verarbeitungsprozesse vereinen.
Zusammengefasst bieten die unterschiedlichen APIs in Flink eine Bandbreite an Optionen, die sich für diverse Anforderungen eignen – von schnellen, simplen Abfragen bis hin zu individuell gestalteten Verarbeitungsworkflows. Diese Flexibilität macht Flink zu einem attraktiven Werkzeug für Entwickler und Unternehmen, die mit Echtzeitdatenströmen arbeiten und dabei von einer hohen Anpassungsfähigkeit profitieren möchten.
Komponenten eines Flink-Deployments
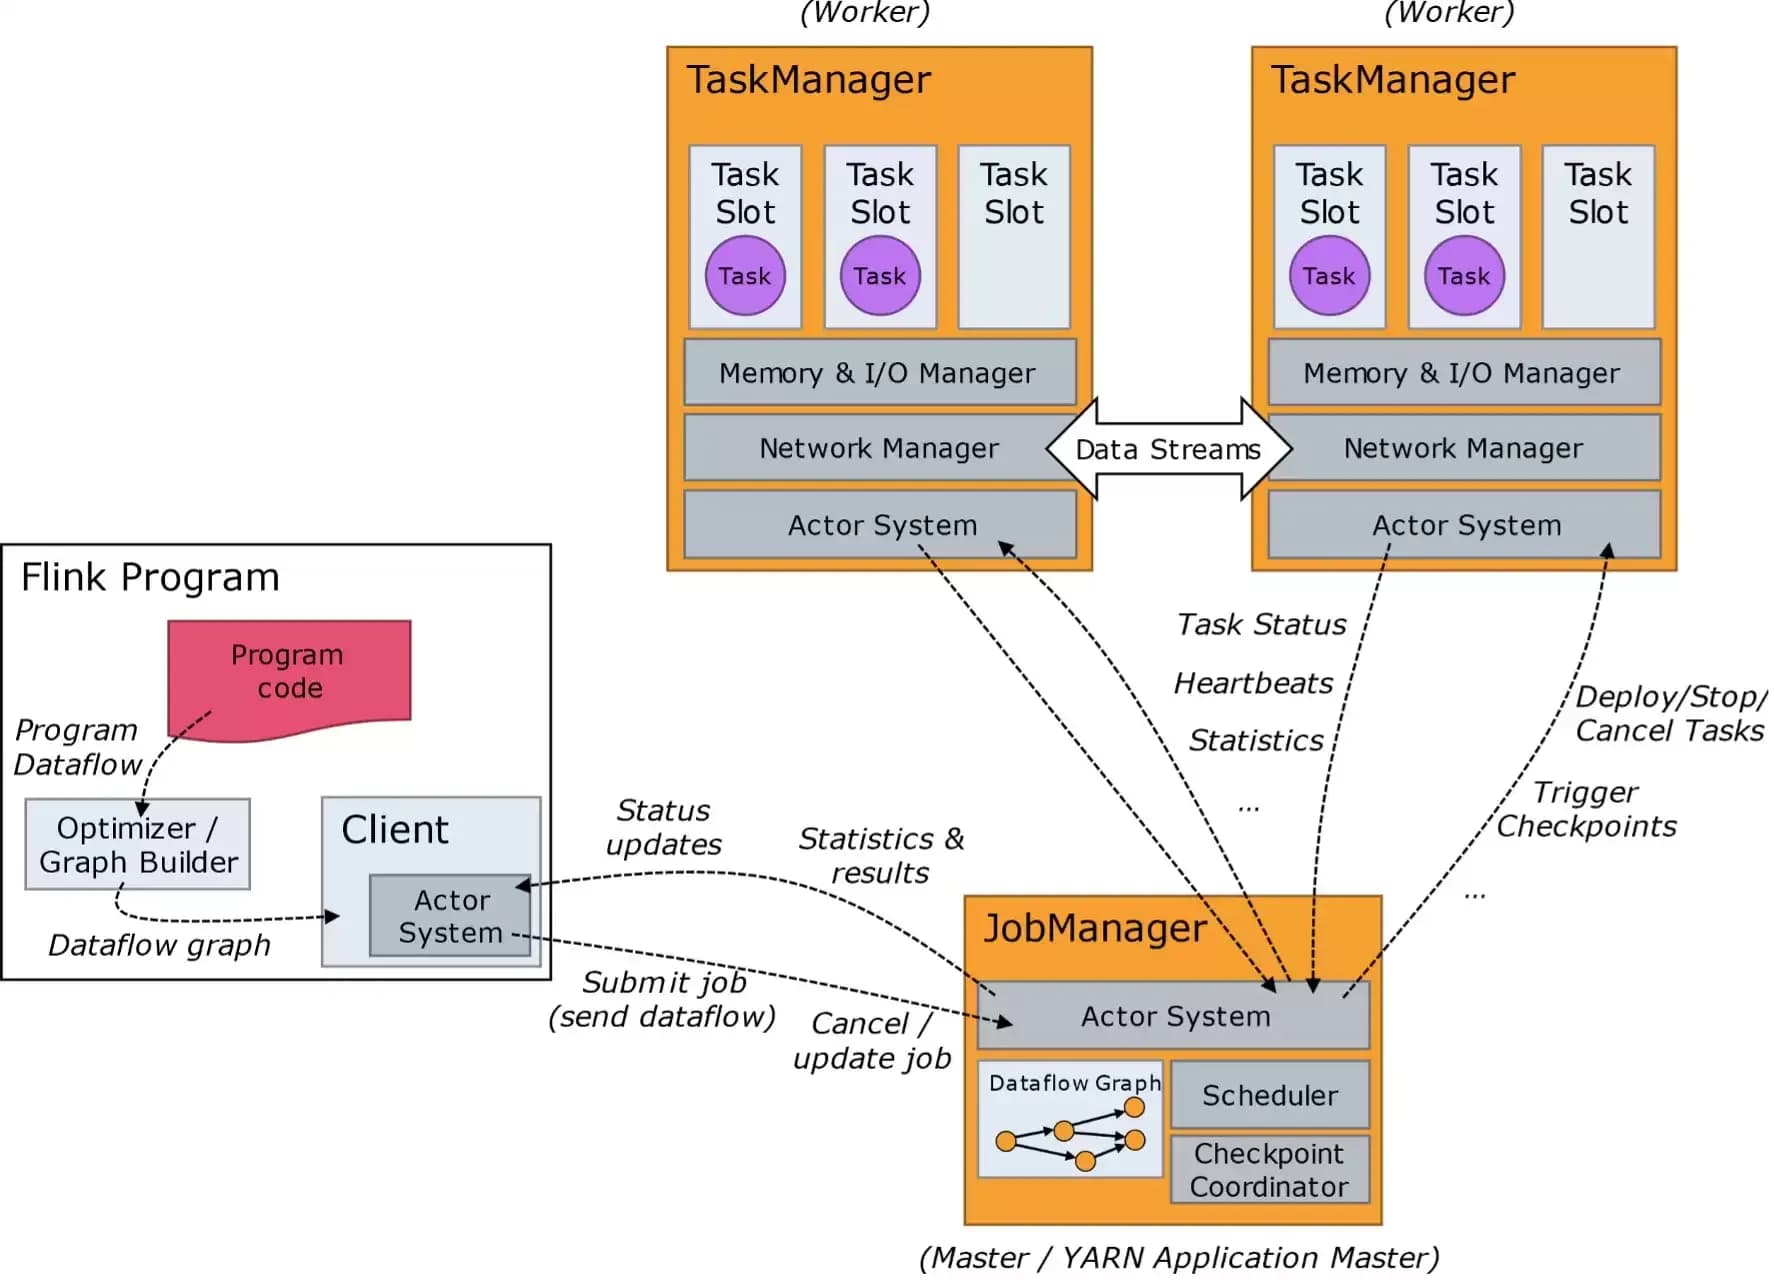
Ein Flink-Deployment besteht aus drei Hauptkomponenten:
- Client: Sendet Datenflüsse an den JobManager und kann sich danach trennen (detached mode) oder verbunden bleiben (attached mode). Er ist nicht Teil der Laufzeit, sondern dient nur dem Start.
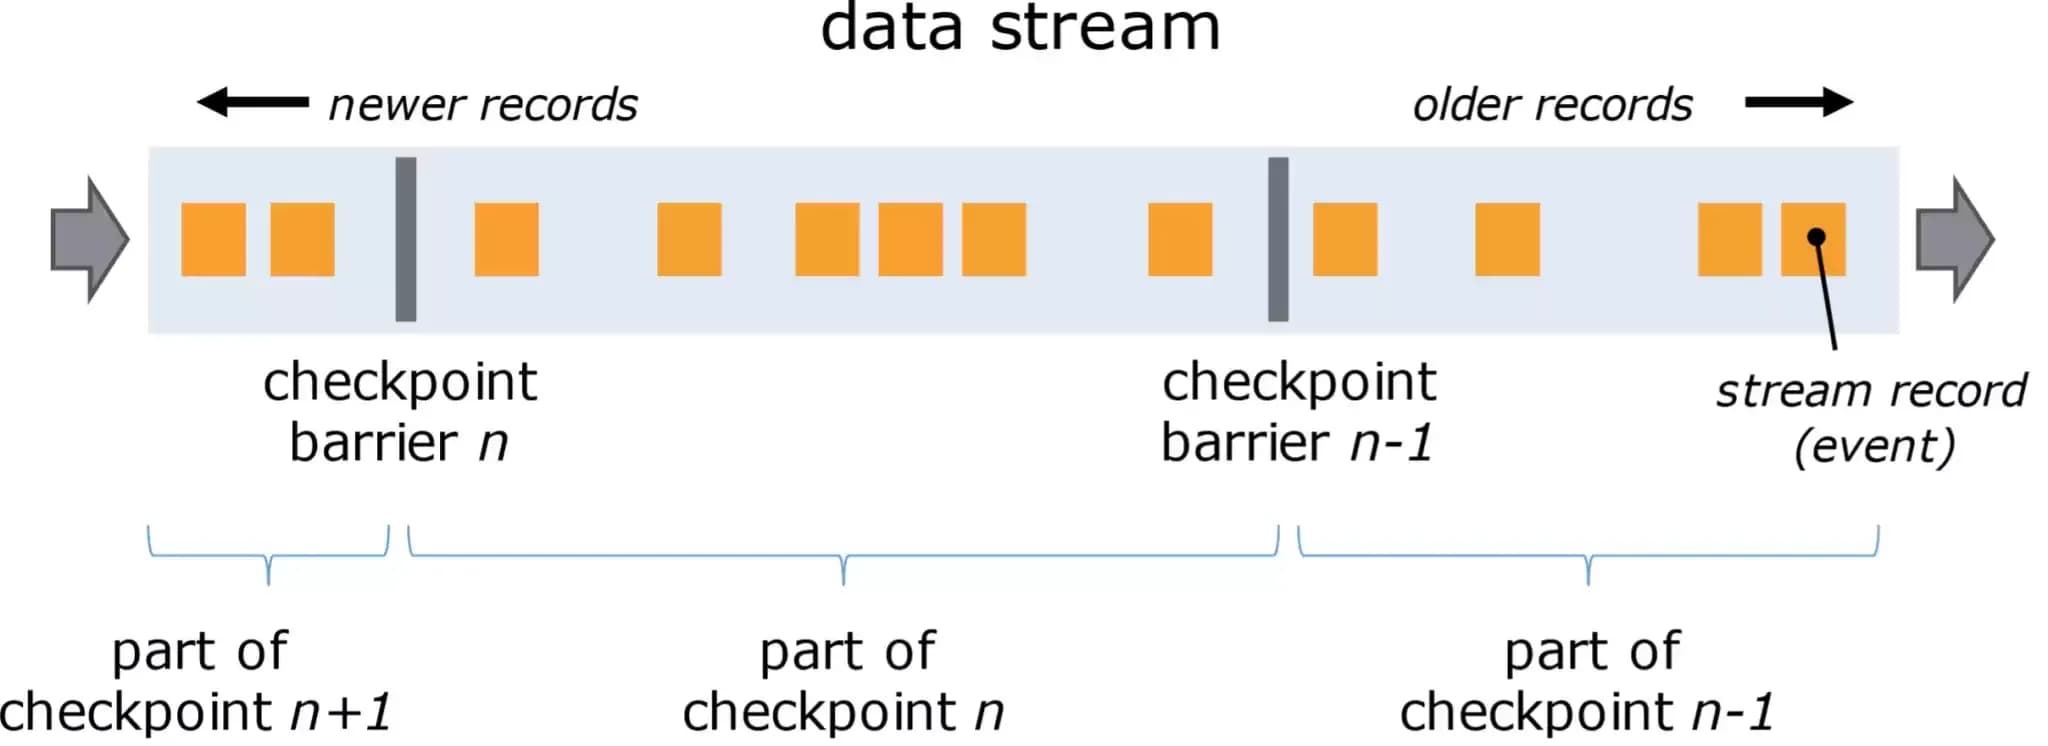
- JobManager: Koordiniert die Ausführung der Flink-Jobs, plant Aufgaben, verwaltet Checkpoints und übernimmt die Wiederherstellung bei Fehlern. In hochverfügbaren Umgebungen gibt es einen Leader und Standby-JobManager.
- TaskManager: Führt die eigentlichen Verarbeitungsschritte aus, puffert und tauscht Daten aus. Jeder TaskManager hat Task-Slots für parallele Aufgaben. Die Anzahl der Slots bestimmt die Verarbeitungskapazität.